Guide till Claude Sonnet 5.5: effort, kostnader och vardagsarbete
Börja med Sonnet 5.5 på medium för tydligt avgränsat arbete. Välj high för djupare undersökningar och jämför med Opus när uppgiften kräver mer resonemang. Det är en användbar utgångspunkt för buggfixar, dokument, återkommande rapporter och automatisering i verksamheten.
Sonnet 5.5 lanserades den 28 september 2026 och kostar 2 USD per miljon indatatoken och 10 USD per miljon utdatatoken. Den största besparingsmöjligheten finns i återkommande arbete med tydliga underlag, en konkret leverans och ett tillförlitligt sätt att kontrollera resultatet.
Välj effort efter uppgiften
Effort styr hur mycket resonemang och verktygsarbete Claude lägger på ett svar. Högre nivåer förbrukar vanligtvis fler token och tar längre tid.
- Low: klassificering, enkel dataextraktion, korta omskrivningar och underagenter med snäva uppdrag. Ange uttryckligen hur resultatet ska kontrolleras, särskilt för kod.
- Medium: tydligt specificerade buggfixar, dokument från tillhandahållet material och verktygsflöden i flera steg. Det är standard vid lanseringen i Claude Code och Claude-apparna.
- High: svårare felsökning, analys och uppgifter som kräver mer undersökning. Det är standard i Claude API. Nivån är också värd att testa för återkommande automatisering i verksamheten.
- Xhigh: krävande arbete där dina tester visar en användbar förbättring jämfört med high. Ta med Opus medium och high i jämförelsen.
- Max: uppgifter där fler godkända resultat motiverar extra tid och kostnad. Ange omfattningen och när arbetet ska avslutas.
Anthropic har kalibrerat om effort för Sonnet 5.5. Gör därför en ny jämförelse med egna uppgifter när du uppgraderar från Sonnet 5. Om medium stannar för tidigt eller hoppar över kontroller, prova high. Om modellen har undersökt ordentligt och ändå gör fel bedömning, jämför med en mer kapabel modell.
Källor: Anthropics vägledning för effort och promptguiden för Sonnet 5.5.
Hur mycket kan Sonnet 5.5 spara?
Med API:ets standardpriser kostar Sonnets indata- och utdatatoken 50 procent mindre än Opus 5.5:s och 80 procent mindre än Fable 5.1:s. Vid samma förbrukning av en miljon indatatoken utanför cache och 200 000 utdatatoken, inklusive debiterade resonemang, blir kostnaden:
- Sonnet 5.5: 4 USD.
- Opus 5.5: 8 USD. Ett byte sparar 4 USD.
- Fable 5.1: 20 USD. Ett byte sparar 16 USD.
Den faktiska besparingen per uppgift beror på tokenförbrukning, effort, omförsök och granskningstid. Exemplen gäller standardavgifter för API-token. Verktyg, leverantörspåslag och skatter tillkommer. Claude Pro och Max har separat abonnemangsdebitering.
Cache påverkar jämförelsen. Cacheläsning kostar 0,20 USD per miljon token för både Sonnet och Opus, och 0,25 USD för Fable. Ju mer arbetsflödet använder cachad indata, desto mindre blir den totala prisskillnaden. Cacheskrivning har egna priser; Sonnet tar 2,50 USD per miljon token för en femminuterscache. Batchbearbetning ger en separat rabatt på 50 procent för indata och utdata.
Jämfört med Sonnet 5 uppger Anthropic upp till 30 procent lägre kostnad per uppgift, genom lägre tokenförbrukning till samma standardpriser per token. Företaget uppger också över 30 procent snabbare generering av utdata. Mät effekten på hela arbetsflödet, inklusive verktyg och granskning.
Källor: officiella priser för Sonnet, Opus och Fable; lanseringen av Sonnet 5.5.
När Opus blir värt att jämföra
Artificial Analysis Intelligence Index v4.3.2 visar hur snabbt Sonnets uppgiftskostnad stiger med effort. Här visas avrundade indexpoäng / viktad genomsnittskostnad i USD per indexuppgift:
- Sonnet 5.5: low 36 / $0.41; medium 41 / $0.59; high 47 / $1.08; xhigh 52 / $2.74; max 56 / $7.60.
- Opus 5.5: low 42 / $0.55; medium 51 / $1.34; high 54 / $1.82; xhigh 56 / $3.46; max 58 / $5.98.
- Fable 5.1: low 47 / $2.37; medium 49 / $2.98; high 51 / $3.91; xhigh 53 / $5.98; max 53 / $7.63.
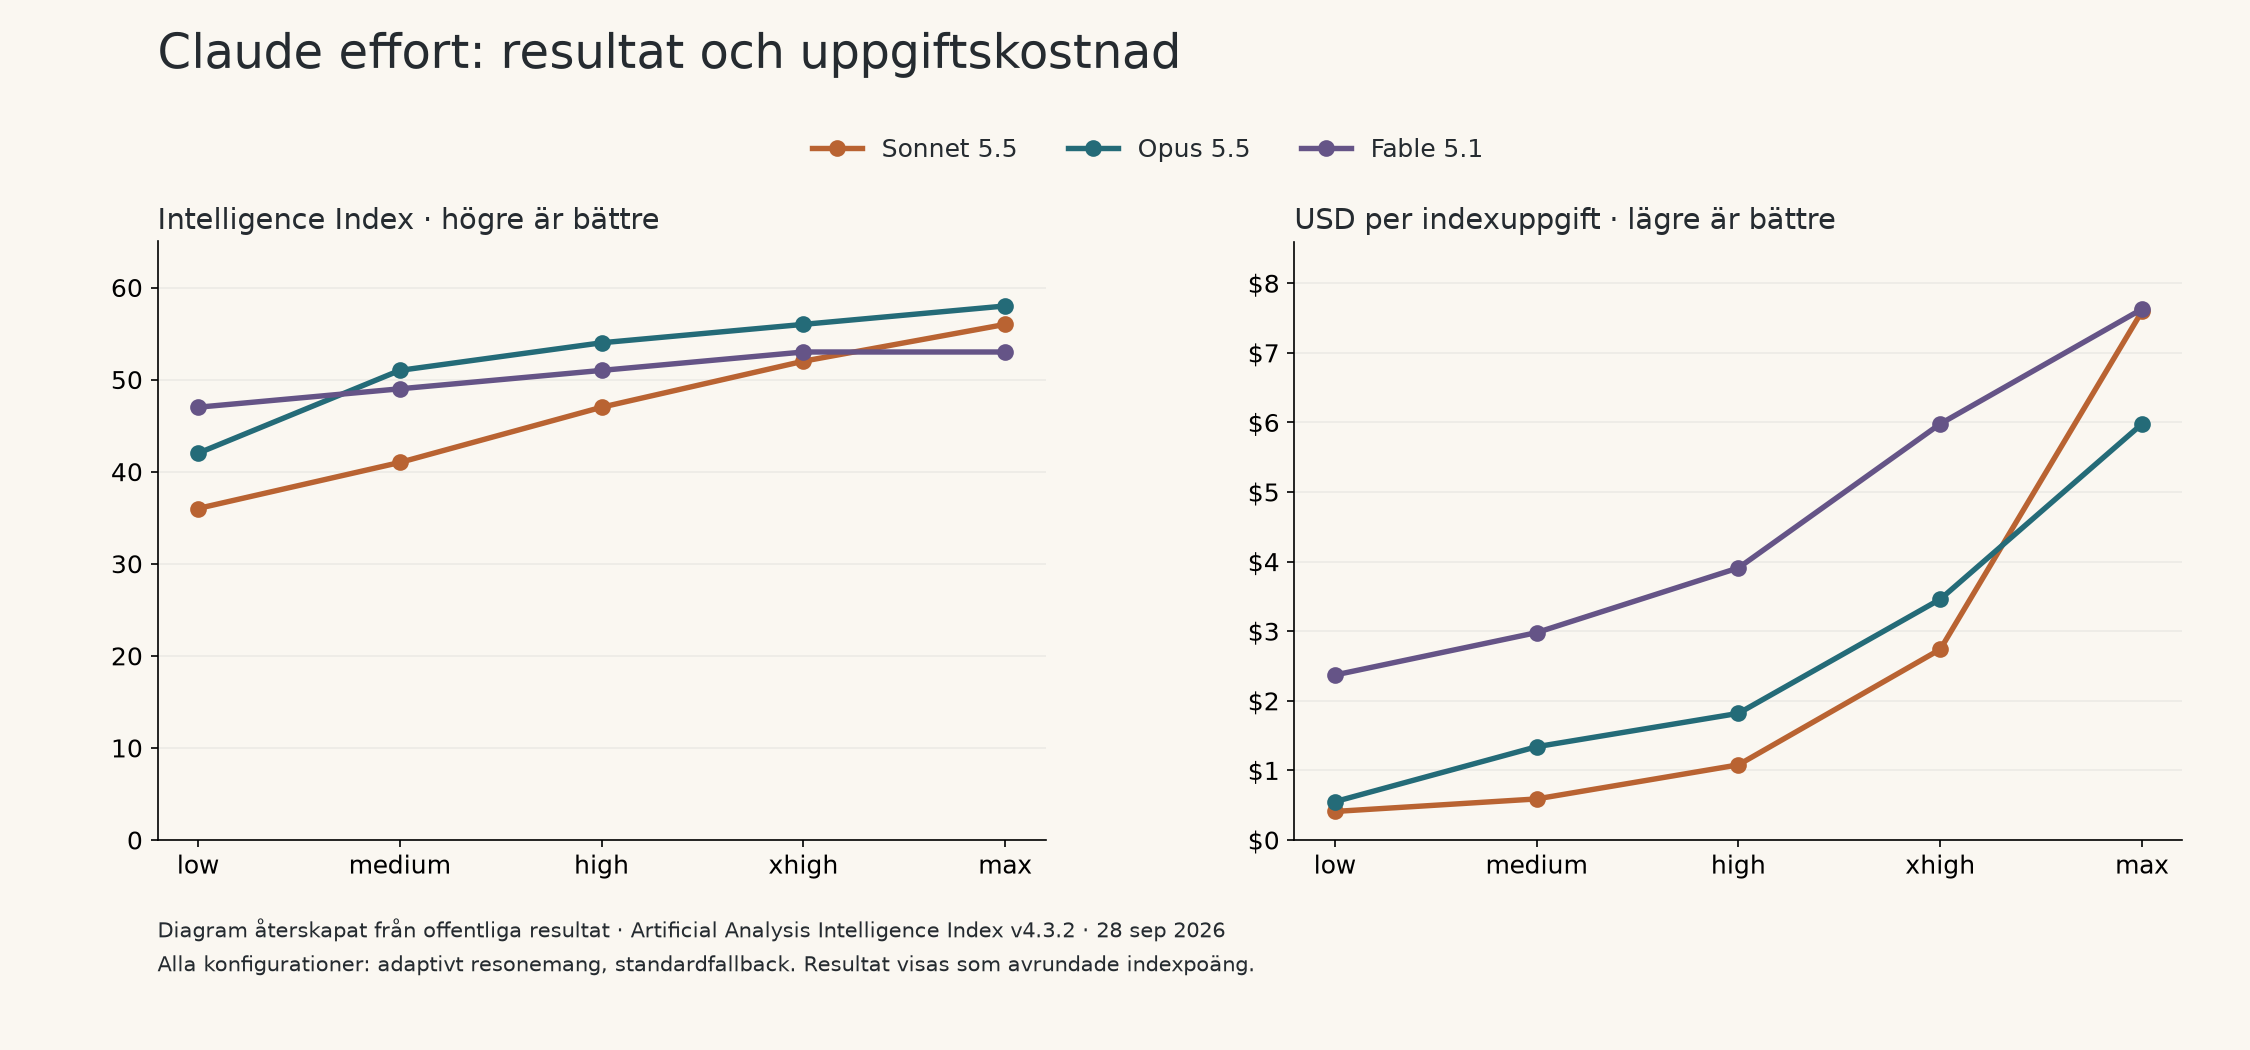
Diagram återskapat från resultaten för Sonnet, Opus och Fable hos Artificial Analysis, kontrollerade den 28 september 2026. Adaptivt resonemang med standardfallback.
De användbara jämförelserna inför ett modellval är:
- Opus low mot Sonnet medium: 42 mot 41 poäng, till 0,55 mot 0,59 USD. Ta med båda i ett test av rutinuppgifter.
- Opus high mot Sonnet xhigh: 54 mot 52 poäng, till 1,82 mot 2,74 USD. Opus kostar cirka 34 procent mindre i den här testmixen.
- Opus xhigh mot Sonnet max: båda visar 56 poäng, till 3,46 mot 7,60 USD. Opus kostar cirka 54 procent mindre vid den avrundade poängen.
Resultaten gäller en främst engelskspråkig blandning av prestandatest. Artificial Analysis uppskattar ett 95-procentigt konfidensintervall på mindre än ±1 procent för det samlade indexet. Enskilda utvärderingar kan ha bredare intervall. När poängen ligger nära varandra är modellerna kandidater att jämföra på dina egna uppgifter. Standardfallback innebär att vissa förfrågningar kan besvaras av en annan modell.
Källa: Artificial Analysis metodbeskrivning.
Ett användbart resultat för automatisering
I AutomationBench-AA får Sonnet high 59,1 procent till cirka 0,344 USD per uppgift, mot 54,7 procent till 1,643 USD för Fable medium: ungefär 79 procent lägre uppgiftskostnad. Opus medium får 61,2 procent till 0,638 USD. Resultatet gör Sonnet high till ett lovande alternativ att testa för återkommande arbetsflöden i verksamheten.
Måttet visar andelen uppfyllda delmål i simulerade SaaS-uppgifter, där uppgifter som bryter mot skyddsreglerna får noll poäng. Resultatet stöder detta specifika användningsområde för automatisering. Prestandan varierar mellan andra utvärderingar.
Källor: Artificial Analysis modelldata och AutomationBench-AA. Uppgiftskostnaderna är beräknade från publicerade viktade kostnadsbidrag och utvärderingsvikter.
Ge Sonnet en tydlig slutpunkt
Sonnet passar för arbete som att ta fram en månadsrapport från bestämda filer, skriva supportutkast från godkänt material eller fixa en bugg med reproducerbara test. Ge modellen källmaterialet, leveransen, avgränsningen och kontrollen som avgör när jobbet är klart.
För en koduppgift:
Åtgärda den rapporterade buggen i fakturaexporten. Återskapa felet, begränsa ändringarna till exportflödet och kör de relevanta testen. Redovisa deras faktiska resultat. Stanna när rättningen klarar kontrollerna. Fråga före destruktiva ändringar eller åtgärder i externa system.
För rapporter: ange mallen och kräv avstämda totalsummor. Vid research: begär aktuella källor och datum. Ge modellen beskärning, zoom eller kodverktyg för informationstäta diagram. I Anthropics tester gav dessa verktyg vid high bättre diagramläsning än enbart max.
Vid xhigh och max hjälper tydliga stoppvillkor till att styra extra granskningsrundor och relaterade ändringar. Anthropics resultat i FrontierCode illustrerar avvägningen: Sonnet fick 52,1 procent med xhigh och 46,2 procent med max. Bland undersökta misslyckanden vid max fanns överskridna tidsgränser och arbete utanför uppdragets omfattning.
Källor: promptguiden för Sonnet och lanseringens benchmarknoter.
Kontrollera detta när du byter modell i ett API-flöde
Använd claude-sonnet-5-5 och sätt output_config.effort uttryckligen. Modellen stöder ett kontextfönster på en miljon token och upp till 128 000 utdatatoken.
- Resonemang och verktyg: använd adaptivt resonemang för resonemangsuppgifter. Läget
between_toolstar bort inledande resonemang vid low, medium och high. Befintliga integrationer med avstängt resonemang eller tvingat verktygsval behöver anpassas. - JSON: för totalsummor, regler och rangordning, använd adaptivt resonemang och be Claude tänka igenom problemet före svaret. Kontrollera resultatet och
stop_reason. Behandlamax_tokenssom ett misslyckat försök, även med giltig JSON, och försök igen inom en begränsad budget. - Budget och cache: ge utrymme för resonemang inom
max_tokensoch sätt en separat budget för hela arbetsflödet. Ändrad effort på toppnivå återställer promptcachen. Ändringar per meddelande som stöds bevarar den med adaptivt resonemang. - Historik och status: se över kompatibiliteten för resonemangsblock och strömning när du flyttar befintliga konversationer eller visar status från verktygsarbete.
- Data och fallback: bekräfta villkoren för datalagring och logga modellen som faktiskt besvarade varje förfrågan. Sonnet erbjuder upplägg med zero data retention. Fable 5.1 har 30 dagars datalagring om inte Anthropic uttryckligen godkänner ett alternativ.
Källor: modellöversikten för Sonnet, promptguiden och Fables krav på datalagring.
Börja med ett litet urval verkliga uppgifter
Kör samma representativa uppgifter med Sonnet medium, Sonnet high och de närmaste Opus-alternativen. Använd samma verktyg, kontext och godkännandekrav. Följ total kostnad, tidsåtgång, omförsök och tid för mänskliga rättningar.
Välj konfigurationen med lägst total kostnad per godkänt resultat. För Sonnet 5.5 är den starkaste utgångspunkten tydligt avgränsat vardagsarbete på medium eller high.
Baserat på offentliga prestandatest och officiell dokumentation kontrollerade den 28 september 2026.
Vanliga frågor
Vilken effort ska jag börja med i Sonnet 5.5?
Börja med medium för tydliga koduppgifter och verktygsflöden i flera steg, high för svårare undersökningar och low för enkla uppgifter som är lätta att kontrollera. Claude Code och apparna använder medium som standard vid lanseringen; API:et använder high.
Hur mycket kan jag spara med Sonnet 5.5?
Standardpriset för indata och utdata är 2/10 USD per miljon token: 50 procent lägre än Opus 5.5 och 80 procent lägre än Fable 5.1 vid samma förbrukning. Den faktiska besparingen beror på effort, cache, omförsök och granskningstid. Cacheläsning kostar 0,20 USD för Sonnet och Opus och 0,25 USD för Fable.
När bör jag jämföra Sonnet med Opus?
Ta med Opus när du överväger Sonnet xhigh eller max, eller när uppgiften kräver starkare omdöme. I Artificial Analysis publicerade resultat får Opus high 54 poäng till 1,82 USD per indexuppgift, mot 52 poäng till 2,74 USD för Sonnet xhigh. Testa båda mot dina egna godkännandekrav.
Smedjans nyhetsbrev
Få nya artiklar i inkorgen
Välj de ämnen som intresserar dig. Inget brus, max ett mejl i veckan.
Vi följer GDPR. Avsluta när du vill.